> FACT: Language model ka fluent jawab accuracy ki guarantee nahi hai; important naam, date, number aur quote ko verify karein.
# चैटबॉट आपको ‘समझता’ क्यों नहीं? टोकन, हैलुसिनेशन और संदर्भ की सीमा
स्क्रीन पर वाक्य इतने चिकने आते हैं कि लगता है सामने कोई बैठा है। वो तुम्हारा नाम दोहराता है, माफी मांगता है, “समझ गया” लिखता है। फिर अगली पंक्ति में कोई किताब गढ़ देता है, कोई तारीख पलट देता है, कोई कानून ऐसा सुना देता है जो कभी पास ही नहीं हुआ। गुस्सा स्वाभाविक है। भ्रम भी। मशीन जादू नहीं है। वो अगला टुकड़ा जोड़ने वाली मशीन है। इसी लेख में वही मशीन खोलेंगे — टोकन, नेक्स्ट-टोकन प्रेडिक्शन, ट्रेनिंग की सीमा, कॉन्टेक्स्ट विंडो, अटेंशन, और वो आदत जिसे लोग हैलुसिनेशन कहते हैं। फोकस सीधा है: why ChatGPT hallucinates — और क्यों कोई भी ऐसा बड़ा भाषा मॉडल कभी-कभी आत्मविश्वास के साथ गलत बोल देता है।
ये लेख किसी प्रोडक्ट की तारीफ या बॉयकॉट का पोस्टर नहीं। ये उस अंतर को साफ करता है जो “समझना” और “संभावित अगला शब्द चुनना” के बीच है। आंकड़े गढ़े नहीं जाएंगे। जो तंत्र है, वही भाषा में उतरेगा।
मशीन जादू क्यों लगती है
इंसान बात करते हुए मतलब पकड़ता है। चेहरा, स्वर, पिछली लड़ाई, कमरे का माहौल — सब एक साथ बैठते हैं। चैटबॉट के पास इनमें से कुछ भी मूल रूप में नहीं होता। उसके पास टेक्स्ट होता है, जिसे छोटे टुकड़ों में तोड़ा गया है, और एक विशाल सांख्यिकीय स्मृति होती है कि ऐसे टुकड़ों के बाद इतिहास में कौन से टुकड़े अक्सर आए।
जब जवाब धाराप्रवाह हिंदी में आता है, दिमाग उसी सर्किट को चलाता है जो किसी पढ़े-लिखे इंसान के लिए आरक्षित है। धाराप्रवाहता को हम ईमानदारी से जोड़ देते हैं। स्कूल से यही सीखा: जो साफ बोलता है, वो जानता है। भाषा मॉडल इसी कमजोरी पर बिना इरादे के सवार हो जाता है। उसका काम “सच बोलना” नहीं, “अगला संभावित टोकन” चुनना है। सच अक्सर उस संभावना के पास होता है। हमेशा नहीं।
“समझ गया” वाला वाक्य भी उसी पैटर्न से निकलता है। ट्रेनिंग डेटा में लाखों बार इंसानों ने बात के बाद “got it” लिखा। मॉडल वही सामाजिक चिकनाई दोहराता है। अंदर कोई छोटा होमुनकुलस नहीं बैठा जो वाकई विषय पकड़ रहा हो।
टोकन क्या होते हैं
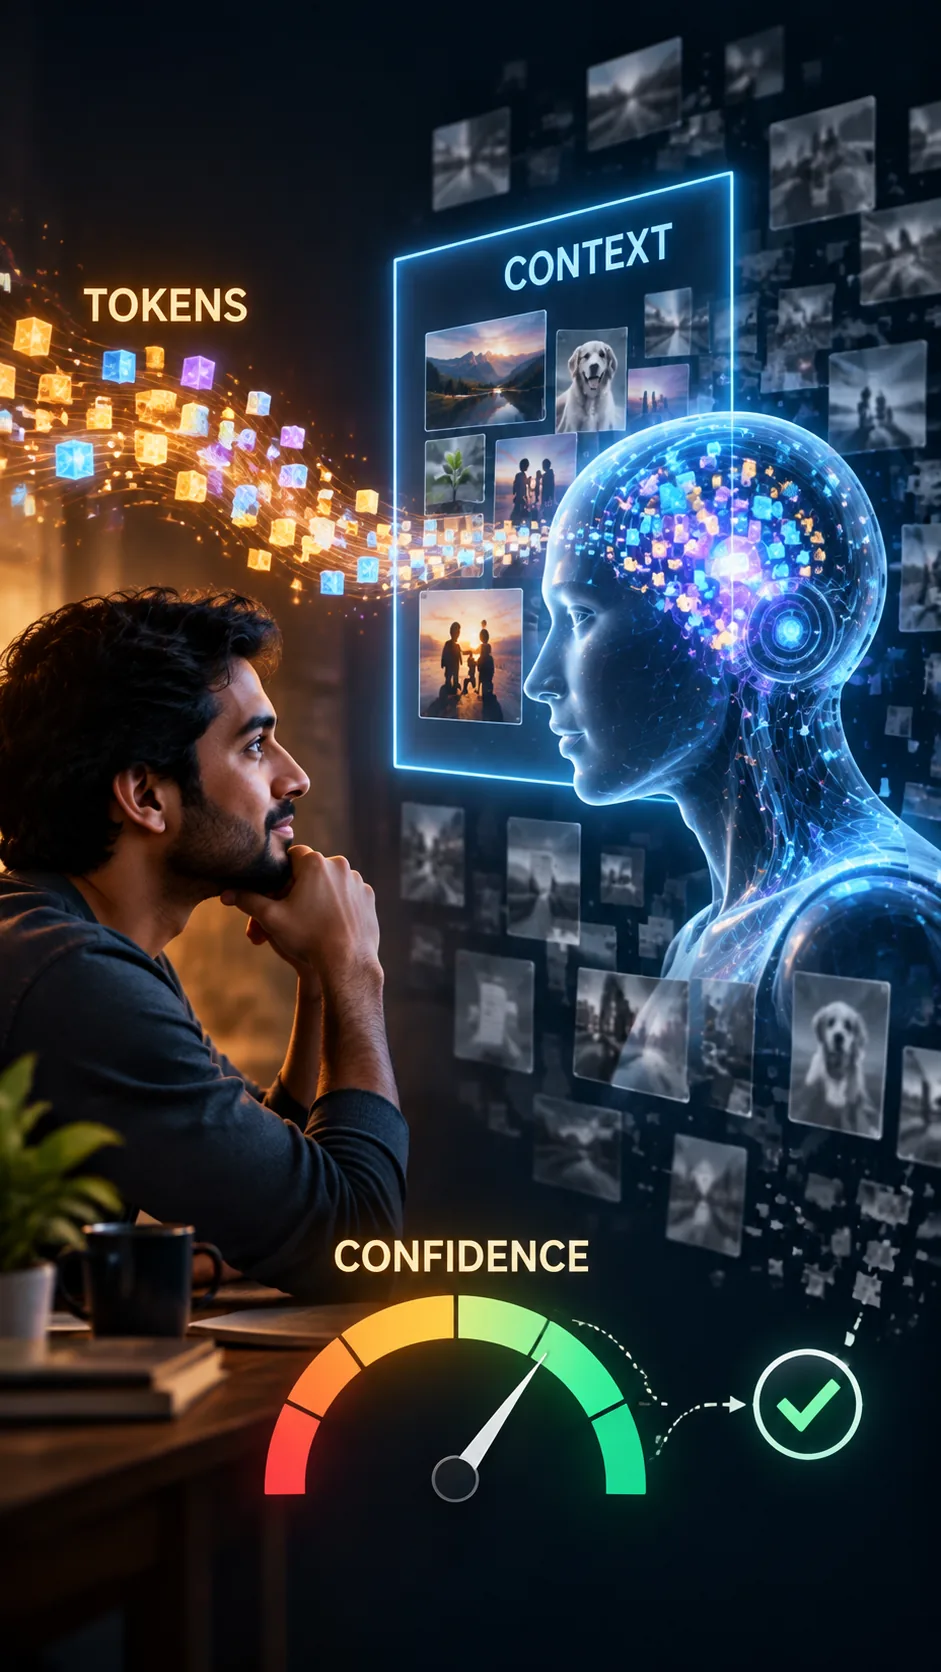
मॉडल अक्षर-अक्षर नहीं सोचता, न हमेशा पूरा शब्द। वो टेक्स्ट को टोकन (tokens) में काटता है। एक टोकन कभी छोटा शब्द होता है, कभी शब्द का टुकड़ा, कभी चिह्न, कभी स्पेस सहित कोई इकाई। अंग्रेजी में एक टोकन अक्सर एक छोटे शब्द या शब्दांश के आसपास बैठता है। हिंदी-देवनागरी में टोकन कट अलग पड़ सकता है, क्योंकि लिपि और उपशब्द की सीमाएँ अंग्रेजी से भिन्न हैं।
तुम जो लंबा संदेश भेजते हो, वो मॉडल के लिए एक टोकन-कतार बन जाता है। जवाब भी टोकन-कतार ही होता है, बस उलटी दिशा में — एक के बाद एक निकलता हुआ। इसलिए “याद रखना” का मतलब अक्सर ये होता है कि वो कतार अभी विंडो में है। विंडो से बाहर गया टुकड़ा मॉडल के लिए इस मोड़ पर मौजूद नहीं, जब तक कोई बाहरी स्मृति या दोबारा चिपकाया गया पाठ न हो।
टोकन की गिनती पैसे और सीमा दोनों तय करती है। लंबा पीडीएफ, पूरी चैट हिस्ट्री, बड़ा कोड — सब विंडो का हिस्सा माँगते हैं। विंडो भर गई तो पुरानी बातें कटीं। कटने के बाद मॉडल वही आत्मविश्वास रख सकता है, क्योंकि उसे ये अहसास नहीं होता कि याददाश्त का पन्ना फट गया। अहसास इंसान का गुण है, संभावना का नहीं।
नेक्स्ट-टोकन प्रेडिक्शन — असली इंजन
बड़े भाषा मॉडल का मूल काम सरल वाक्य में ये है: अब तक जो टोकन आए, उनके बाद अगला टोकन किस वितरण से चुनूँ। लाखों-करोड़ों संभावित टुकड़ों पर संभावनाएँ बैठती हैं। फिर एक टुकड़ा चुना जाता है — कभी सबसे ऊँची संभावना, कभी थोड़ा यादृच्छिक स्वाद (temperature) के साथ। फिर ये नया टुकड़ा इतिहास में जुड़ता है, और खेल दोहराया जाता है।
पूरा पैराग्राफ एक साथ “सोचकर” नहीं उतरता। वो एक-एक ईंट से दीवार बनता है। शुरुआती ईंट थोड़ी तिरछी हुई तो दीवार तिरछी निकल सकती है — और मॉडल उसी तिरछी दीवार को और चिकना करने में लग जाता है, क्योंकि चिकना वाक्य ट्रेनिंग में इनाम पाता रहा है।
इसे नेक्स्ट-टोकन प्रेडिक्शन (next-token prediction) कहते हैं। समझने वाली बात ये है कि लक्ष्य “दुनिया का नक्शा सही रखना” नहीं, “इस क्रम के बाद जो क्रम डेटा में प्राकृतिक लगता है, उसे जारी रखना” है। डेटा में गलतियाँ थीं तो गलती का पैटर्न भी प्राकृतिक लग सकता है। डेटा में दो विरोधी दावे थे तो मॉडल कभी एक, कभी दूसरा, कभी दोनों का मिश्रण दे सकता है — बिना ये जाने कि वो मिश्रण असंभव है।
यही वजह है कि मॉडल तुम्हारे अधूरे वाक्य पूरे कर देता है। अधूरापन उसके लिए एक कतार है, जिसे सबसे संभावित तरीके से बढ़ाना है। इंसान अधूरे वाक्य में इरादा पढ़ता है। मॉडल इरादा नहीं पढ़ता, सांख्यिकीय जारीकरण करता है।
ट्रेनिंग डेटा और ज्ञान की सीमा
मॉडल वजनों में दुनिया नहीं रखता जैसे अलमारी में फाइलें हों। वो सांख्यिकीय संबंध रखता है। ट्रेनिंग के समय अरबों पन्ने, संवाद, कोड, किताबें, फोरम — सब टोकन कतार बनकर वजन अपडेट करते हैं। जो चीज बार-बार, कई स्रोतों में, एक जैसे रूप में आई, वो बाद में स्थिर उतरती है। जो चीज कम आई, विरोधाभासी आई, या कटऑफ के बाद घटी, वो कमजोर या गायब रहती है।
यहाँ तीन सीमाएँ साफ हैं। पहली: समय। वजन जमे तो उसके बाद की खबर मॉडल के अंदर अपने आप नहीं घुसती, जब तक नया ट्रेन, नया अपडेट, या बाहरी खोज-उपकरण न हो। दूसरी: दुर्लभ तथ्य। किसी छोटे आदेश, स्थानीय नियम, निजी दस्तावेज का विवरण डेटा में या तो नहीं था या इतना पतला था कि वजन उस पर मजबूत नहीं बना। तीसरी: मिश्रण। दो सच्ची बातें अलग-अलग जगह थीं; मॉडल ने उन्हें एक वाक्य में इस तरह जोड़ दिया जैसे वो एक ही घटना हों। जोड़ चिकना निकला, सत्य नहीं।
“ज्ञान” शब्द यहाँ लापरवाही से इस्तेमाल होता है। इंसान ज्ञान को जाँच, अनुभव, संदेह से बाँधता है। मॉडल के वजन में पैटर्न है। पैटर्न अक्सर ज्ञान जैसा व्यवहार करता है — राजधानी, सूत्र, मुहावरा। पैटर्न वहीं टूटता है जहाँ दुनिया टेढ़ी है: नई घटना, निजी केस, दो स्रोतों का टकराव, या ऐसा सवाल जिसका जवाब डेटा में कभी एक वाक्य में लिखा ही नहीं गया।
फाइन-ट्यूनिंग और सिस्टम निर्देश मॉडल को शैली, सुरक्षा, संक्षेप सिखा सकते हैं। वो जादू से सत्य सेंसर नहीं लगा देते। निर्देश “अनुमान मत लगाओ” लिखो, फिर भी अगला टोकन चुपचाप अनुमान की ओर जा सकता है, क्योंकि अनुमान वाला पूरा वाक्य ट्रेनिंग में बहुत सुंदर लगता रहा है।
कॉन्टेक्स्ट विंडो — कमरे की दीवार
हर चैट एक कमरा है जिसकी दीवारें टोकन से बनी हैं। इस कमरे को कॉन्टेक्स्ट विंडो (context window) कहते हैं। सिस्टम निर्देश, तुम्हारे पुराने संदेश, मॉडल के पुराने जवाब, अटैच की गई फाइल — सब उसी कमरे में बैठते हैं। कमरा बड़ा हो तो लंबी बात टिकती है। फिर भी कमरा अनंत नहीं।
दीवार के बाहर जो बात सुबह कही गई, दोपहर की विंडो में मौजूद नहीं रह सकती। मॉडल तब भी लिख सकता है “जैसा आपने पहले कहा” — ये वाक्य सामाजिक आदत है, स्मृति प्रमाण नहीं। लंबी चैट में शुरुआत का तथ्य दब जाता है, बीच का सुधार खो जाता है, आखिरी संदेश भारी पड़ जाता है। यूजर सोचता है बातचीत एक दिमाग है। तंत्र सोचता है: इस कतार पर अगला टोकन।
फाइल अपलोड भी विंडो का हिस्सा माँगती है। पूरा उपन्यास घुसाया, मॉडल ने सार सुनाया, फिर पेज 214 का वाक्य गलत बताया — हो सकता है वह पेज कतार में पूरा टोकन-रूप में टिका ही न हो, या अटेंशन ने उसे कम वजन दिया हो। “पढ़ लिया” का मतलब इंसान वाला पढ़ना नहीं।
अटेंशन और ताजगी का पक्षपात
ट्रांसफॉर्मर मॉडल अटेंशन (attention) से काम करते हैं। हर नई स्थिति में मॉडल ये तौलता है कि पिछली कतार के कौन से टोकन अभी ज्यादा प्रासंगिक लगते हैं। ये तंत्र शक्तिशाली है। ये पूर्ण स्मृति नहीं है। लंबे संदर्भ में कुछ वाक्य चमकते हैं, कुछ धुंधले। आखिरी निर्देश अक्सर ज्यादा जोर पकड़ते हैं — रिकेंसी (recency)। पहली शर्त दब सकती है।
इसीलिए एक ही चैट में तुमने पहले कहा “केवल आधिकारिक नियम”, बाद में पूछा “फिर भी अनुमान से बता दो”, तो मॉडल दूसरी पंक्ति का स्वाद ले सकता है। इंसान दोनों वाक्यों को एक अनुबंध मानता है। अटेंशन भार बदलता रहता है। दो विपरीत निर्देश एक साथ हों तो चिकना समझौता निकल सकता है, जो दोनों को आधा तोड़ता है।
अटेंशन ये भी नहीं देखता कि कौन सा वाक्य संसार में सत्य है। वो देखता है कौन सा टोकन इस कतार में सांख्यिकीय रूप से जुड़ा लगता है। जुड़ाव सत्य की गारंटी नहीं।
हैलुसिनेशन का मैकेनिक्स
हैलुसिनेशन (hallucination) यहाँ फिल्मी भूत नहीं। व्यावहारिक मतलब: मॉडल ऐसा विवरण दे जो धाराप्रवाह हो, प्रश्न के ढाँचे में बैठता हो, पर तथ्य, स्रोत, या तर्क में गलत / गढ़ा हो। Why ChatGPT hallucinates — इसका उत्तर एक साजिश नहीं, कई पटरियों का योग है।
पहली पटरी: अगला टोकन सच से ज्यादा “लगता हुआ वाक्य” चुनता है। अदालती फैसले का नाम, पेपर का शीर्षक, धारा संख्या — ये सांचे डेटा में बहुत मिलते हैं। सांचे में नया नाम भरना आसान है। नाम वास्तविक हो ये जरूरी नहीं।
दूसरी पटरी: अज्ञान पर चुप रहना ट्रेनिंग में कम इनाम पाता रहा। इंसानों के संवाद में अधूरा जवाब निराशा पैदा करता है। मॉडल ने सीखा कि कोई न कोई पूरा उत्तर बेहतर लगता है। “पता नहीं” छोटा वाक्य है। गढ़ा हुआ पूरा पैराग्राफ लंबा और संतोषजनक लगता है — मॉडल के स्कोर में, दुनिया के सच में नहीं।
तीसरी पटरी: दुर्लभ सवाल। जितना सवाल विचित्र, उतना डेटा पतला। पतले डेटा पर संभावना का शिखर कई गलत चोटियों में बँट जाता है। मॉडल एक चोटी चुन लेता है और उसी पर निबंध उतार देता है।
चौथी पटरी: आंतरिक संगति का दबाव। पहली पंक्ति में गलत साल निकल आया। अगले टोकन उसी साल को सच मानकर कहानी आगे बढ़ाते हैं। दीवार तिरछी, प्लास्टर चिकना।
पाँचवीं पटरी: यूजर का ढाँचा। “पेपर का पूरा रेफरेंस दो”, “केस लॉ उद्धृत करो”, “स्रोत सहित बताओ” — ये निर्देश मॉडल को स्रोत-जैसी स्ट्रिंग बनाने पर मजबूर कर सकते हैं। स्ट्रिंग का रूप सही, अंदर की पहचान गढ़ी। रूप की नकल सामग्री की जाँच नहीं है।
छठी पटरी: बहुभाषी और मिश्रित तथ्य। हिंदी सवाल, अंग्रेजी ज्ञान, आधा अनुवाद। इकाईयाँ सरकती हैं — नाम, धारा, शहर। सरकना आत्मविश्वास घटाए ये जरूरी नहीं।
हैलुसिनेशन हमेशा झूठ बोलने की नीयत नहीं। नीयत यहाँ एक इंसान का शब्द है। तंत्र के लिए ये उच्च-संभावित जारीकरण है, जो इस बार दुनिया से टकरा गया।
आत्मविश्वास बनाम सटीकता
मॉडल के जवाब में विराम, जोड़, “निश्चित रूप से”, “स्पष्ट है” — ये टोकन भी संभावना से आते हैं। ट्रेनिंग डेटा में विशेषज्ञ अक्सर निश्चित भाषा बोलते हैं। इसलिए निश्चित भाषा का सांख्यिकीय वजन ऊँचा है। ऊँची निश्चित भाषा ऊँची सटीकता नहीं।
कुछ सिस्टम अलग से कॉन्फिडेंस स्कोर निकालने की कोशिश करते हैं। वो स्कोर भी मॉडल की आंतरिक संभावना हो सकता है, संसार से मिलान नहीं। संभावना ये कहती है: इस कतार के बाद ये वाक्य कितना प्राकृतिक है। प्राकृतिक होना सही होने से अलग सवाल है।
इंसान उलटा पढ़ता है। जो बिना हिचक बोले, उसे जानकार मानो। चैटबॉट हिचक को शैली में कम रखता है, क्योंकि हिचक वाले जवाब कम “पूरे” लगते हैं। पूरा लगना खतरनाक सुंदरता है।
यही वजह है कि गलती पर पकड़े जाने के बाद मॉडल तुरंत माफी और नया संस्करण दे सकता है — फिर नया संस्करण भी गढ़ा हो सकता है। माफी एक सीखा हुआ संवाद पैटर्न है। सुधार की गारंटी नहीं।
प्रॉम्प्ट की अस्पष्टता
सवाल अधूरा हो तो मॉडल अधूरेपन को भरता है। “क्या ये लीगल है?” — कौन सा राज्य, कौन सी तारीख, कौन सा पक्ष। खाली जगह को औसत कहानी से पटाना उसके काम का हिस्सा है। औसत कहानी तुम्हारे केस से न मिले तो तुम्हें धोखा लगता है। तंत्र ने धोखा देने का फैसला नहीं किया; उसने सबसे सामान्य जारीकरण चुना।
कई निर्देश एक साथ: छोटा लिखो, पूरा लिखो, स्रोत दो, सरल भाषा, कानूनी सटीकता। ये निर्देश टोकन कतार में एक-दूसरे से टकराते हैं। अटेंशन किसी को ज्यादा वजन देगा। नतीजा अक्सर एक चिकना समझौता होता है जो हर लक्ष्य को दस प्रतिशत तोड़ता है।
भूमिका भी भ्रम बढ़ाती है। “तुम वकील हो” लिखने से मॉडल वकील वाली भाषा उतारता है। भाषा विशेषज्ञता नहीं है। भूमिका प्रॉम्प्ट शैली बदलती है, लाइसेंस नहीं देती, अदालत नहीं खोलती, जिम्मेदारी नहीं उठाती।
खोज, टूल और जाँच — क्या हैलुसिनेशन खत्म करते हैं
जब सिस्टम बाहरी खोज, कैलकुलेटर, कोड चालन या डेटाबेस से जोड़ता है, तो कुछ किस्म की गलतियाँ घटती हैं। ताजा घटना, उद्धरण, संख्या — ये वजन की स्मृति से बेहतर, किसी स्रोत से आ सकते हैं। फिर भी श्रृंखला टूट सकती है। खोज गलत नतीजा लाई। मॉडल ने सही नतीजे को गलत सार दिया। स्रोत का वाक्य संदर्भ से कट गया। टूल चला नहीं, मॉडल ने चला होने का नाटक लिख दिया — ये भी एक हैलुसिनेशन है, औजार वाले युग में।
रिट्रीवल (retrieval) दस्तावेज के टुकड़े विंडो में चिपकाता है। टुकड़े अधूरे हों, गलत पेज हों, या सवाल से हल्के जुड़े हों, तो जवाब उसी अधूरेपन को चिकना कर देगा। “स्रोत सहित” तब भी स्रोत के बाहर की पंक्ति जोड़ सकता है, क्योंकि जोड़ने की आदत मजबूत है।
जाँच इंसान का काम रह जाता है। खासकर: नाम, तारीख, धारा, दवा की मात्रा, पैसे का हिसाब, उद्धरण। जो चीज दुनिया में एक रिकॉर्ड रखती है, उसे रिकॉर्ड से मिलाओ। जो चीज राय है, उसे राय ही रहने दो। मॉडल दोनों को एक जैसी चिकनाई से लिख सकता है।
Everyday नतीजे: कहाँ चोट लगती है
स्वास्थ्य, कानून, कर, निवेश — यहाँ धाराप्रवाह गलती महँगी है। स्कूल का असाइनमेंट — गढ़ा उद्धरण पकड़ा जाता है। ऑफिस की नीति — मॉडल पुरानी चैट की अधूरी बात को नियम बना देता है। कोड — कोई फंक्शन ऐसा नाम से चला आता है जो लाइब्रेरी में है ही नहीं।
कम जोखिम वाली जगहें भी हैं: किसी विचार को तोड़ना, भाषा सुधारना, ढाँचा सुझाना, ड्राफ्ट का कंकाल। वहाँ मॉडल काम का साथी है, गवाह नहीं। फर्क इरादे का है। गवाह से सबूत माँगते हैं। साथी से ड्राफ्ट। ड्राफ्ट को सबूत मानना वही पुरानी गलती है — धाराप्रवाहता को ज्ञान मान लेना।
Advice
मशीन से बात करते समय तीन खाने बनाओ। पहला: वो जो जाँचा जा सकता है — नाम, आंकड़ा, धारा, लिंक, कोटेशन। इन्हें जवाब के बाद मूल स्रोत पर उतारो। दूसरा: वो जो संरचना है — रूपरेखा, सवालों की सूची, भाषा की सफाई। इन्हें स्वतंत्र सोच की मदद मानो। तीसरा: वो जो प्रतीत होता है आत्मविश्वास — “निश्चित है”, “स्पष्ट है”। इन शब्दों को सजावट समझो, प्रमाण नहीं।
एक चैट में एक काम दो। लंबे उपन्यास में दस निर्देश मत भींचो। जरूरी शर्तें आखिर में दोहराओ, क्योंकि रिकेंसी अटेंशन को खींचती है। फाइल दो तो पूछो कि कौन सा पेज इस्तेमाल हुआ; जवाब में पेज न मिले तो मानो सार अधूरा हो सकता है।
गढ़े संदर्भ की भूख कम करो। “पाँच पेपर के पूरे APA रेफरेंस दो” जैसा आदेश स्रोत-जैसी स्ट्रिंग मंगाता है। बेहतर आदेश: “जो निश्चित न हो वो मत लिखो; अनिश्चितता अलग पंक्ति में बताओ।” फिर भी गारंटी नहीं। गारंटी सिर्फ तुम्हारी जाँच है।
महत्वपूर्ण फैसले — दवा, मुकदमा, कर, बड़ी रकम — योग्य इंसान और आधिकारिक पन्ने के बिना मत बंद करो। चैटबॉट वहाँ पहला ड्राफ्ट हो सकता है, अंतिम दस्तखत नहीं।
गलती पकड़ो तो उसी चैट में सुधार पर पूरा भरोसा मत टिकाओ। नई कतार पुरानी गलती को आधार मानकर और सजा सकती है। तथ्य को बाहर निकालो, अलग जगह जाँचो, फिर साफ निर्देश के साथ छोटा सवाल पूछो।
💡 कॉलआउट: जो वाक्य सुंदर लगे, उसे पहले संदेह की मेज पर रखो। सुंदरता मॉडल का कौशल है; सत्य संसार का गुण है। दोनों एक टोकन में नहीं बँधे।
बच्चों और नौसिखियों को यही एक वाक्य सिखाओ: ये औजार अगला शब्द जोड़ता है, गवाह नहीं बनता। औजार अच्छा हो सकता है। गवाह अलग परीक्षा देता है।
निष्कर्ष
चैटबॉट तुम्हें इसलिए नहीं “समझता” कि उसके पास समझने वाला मन नहीं, टोकन कतार और नेक्स्ट-टोकन प्रेडिक्शन है। ट्रेनिंग पैटर्न देती है, अनंत ज्ञान नहीं। कॉन्टेक्स्ट विंडो कमरा सीमित करती है। अटेंशन कुछ पंक्तियों को चमकती है, बाकी को धुंध। हैलुसिनेशन अक्सर उसी इंजन का साइड इफेक्ट है जो वाक्य को इतना मानवीय बनाता है — संभावना का चिकना जारीकरण, जब डेटा पतला हो, निर्देश टकराएँ, या रूप की नकल सामग्री से आगे निकल जाए। आत्मविश्वास की भाषा सटीकता की रसीद नहीं। टूल और खोज कुछ छेद बंद करते हैं, सब नहीं। समझदारी इसमें है कि मशीन को जादू की कुर्सी से उतारो और मेज पर औजार की तरह रखो। औजार तेज होता है। औजार अपने काम की जिम्मेदारी नहीं लेता। वो तुम्हारे हिस्से रहती है।
FAQ
1. चैटबॉट जानबूझकर झूठ बोलता है क्या?
नहीं, उस अर्थ में नहीं जिस अर्थ में इंसान झूठ बोलता है। वो अगला संभावित टोकन चुनता है। कभी वह चयन दुनिया से टकराता है। नीयत का नाटक मत पढ़ो; तंत्र पढ़ो।
2. लंबी चैट में वो मेरी पुरानी बात क्यों भूल जाता है?
कॉन्टेक्स्ट विंडो सीमित होती है। पुराने टोकन कट सकते हैं या अटेंशन में हल्के पड़ सकते हैं। “भूलना” मन की कमजोरी नहीं, कतार की सीमा है।
3. क्या बेहतर प्रॉम्प्ट हैलुसिनेशन खत्म कर देता है?
घट सकता है, खत्म नहीं। साफ दायरा, “न जानो तो कहो”, छोटे सवाल मदद करते हैं। दुर्लभ तथ्य और स्रोत-माँग अभी भी गढ़ा रूप ला सकते हैं।
4. खोज या प्लगइन चालू हो तो जवाब हमेशा सही?
नहीं। गलत नतीजा, गलत सार, अधूरा टुकड़ा, या टूल के बिना टूल वाले नाटक की संभावना रहती है। स्रोत खोलो।
5. धाराप्रवाह जवाब को कैसे पढ़ूँ?
ढाँचे और भाषा के लिए उपयोगी मानो। नाम, तारीख, आंकड़ा, कानून, दवा, उद्धरण को बाहरी रिकॉर्ड से मिलाओ। निश्चित स्वर को सजावट समझो।
*डिस्क्लेमर: ये सामान्य तकनीकी समझ है, किसी खास प्रोडक्ट की गारंटी या कानूनी सलाह नहीं। महत्वपूर्ण विषयों पर आधिकारिक स्रोत और योग्य पेशेवर से जाँच करें।*
Word count: 2410
डिस्क्लेमर: AI शैक्षिक व्याख्या है। महत्वपूर्ण फैक्ट्स स्वयं जाँचें।