चॅटबॉट तुम्हाला का समजत नाही? टोकन, हॅल्युसिनेशन आणि संदर्भाच्या मर्यादा
स्क्रीनवर येणारे वाक्य इतके सहज आणि स्वाभाविक वाटतात की जणू काही समोर माणूसच बोलत आहे. तो तुमचे नाव घेतो, माफी मागतो, ‘समजले’ असे लिहितो. पण पुढच्याच क्षणी तो एखादे पुस्तक रचू शकतो, तारीख बदलू शकतो किंवा असा कायदा सांगू शकतो जो कधी अस्तित्वातच नव्हता. अशा वेळी राग येणे किंवा गोंधळणे स्वाभाविक आहे. पण लक्षात ठेवा, मशीन म्हणजे जादू नाही. ती फक्त पुढचा संभाव्य शब्द जोडणारी एक प्रणाली आहे. या लेखात आपण ही प्रणाली उलगडून पाहणार आहोत – टोकन (tokens), नेक्स्ट-टोकन प्रेडिक्शन (next-token prediction), ट्रेनिंगच्या मर्यादा (training limitations), कॉन्टेक्स्ट विंडो (context window), अटेंशन (attention) आणि ज्याला लोक ‘हॅल्युसिनेशन’ (hallucination) म्हणतात, ते काय आहे. आमचा उद्देश हा आहे की ChatGPT किंवा इतर मोठे भाषा मॉडेल (Large Language Models – LLMs) कधीकधी आत्मविश्वासाने चुकीची माहिती का देतात, हे स्पष्ट करणे आहे. हा लेख कोणत्याही उत्पादनाची जाहिरात किंवा टीका करण्यासाठी नाही. ‘समजणे’ आणि ‘पुढचा संभाव्य शब्द निवडणे’ यातील फरक स्पष्ट करणे हा आमचा उद्देश आहे.
मशीन जादू का वाटते?
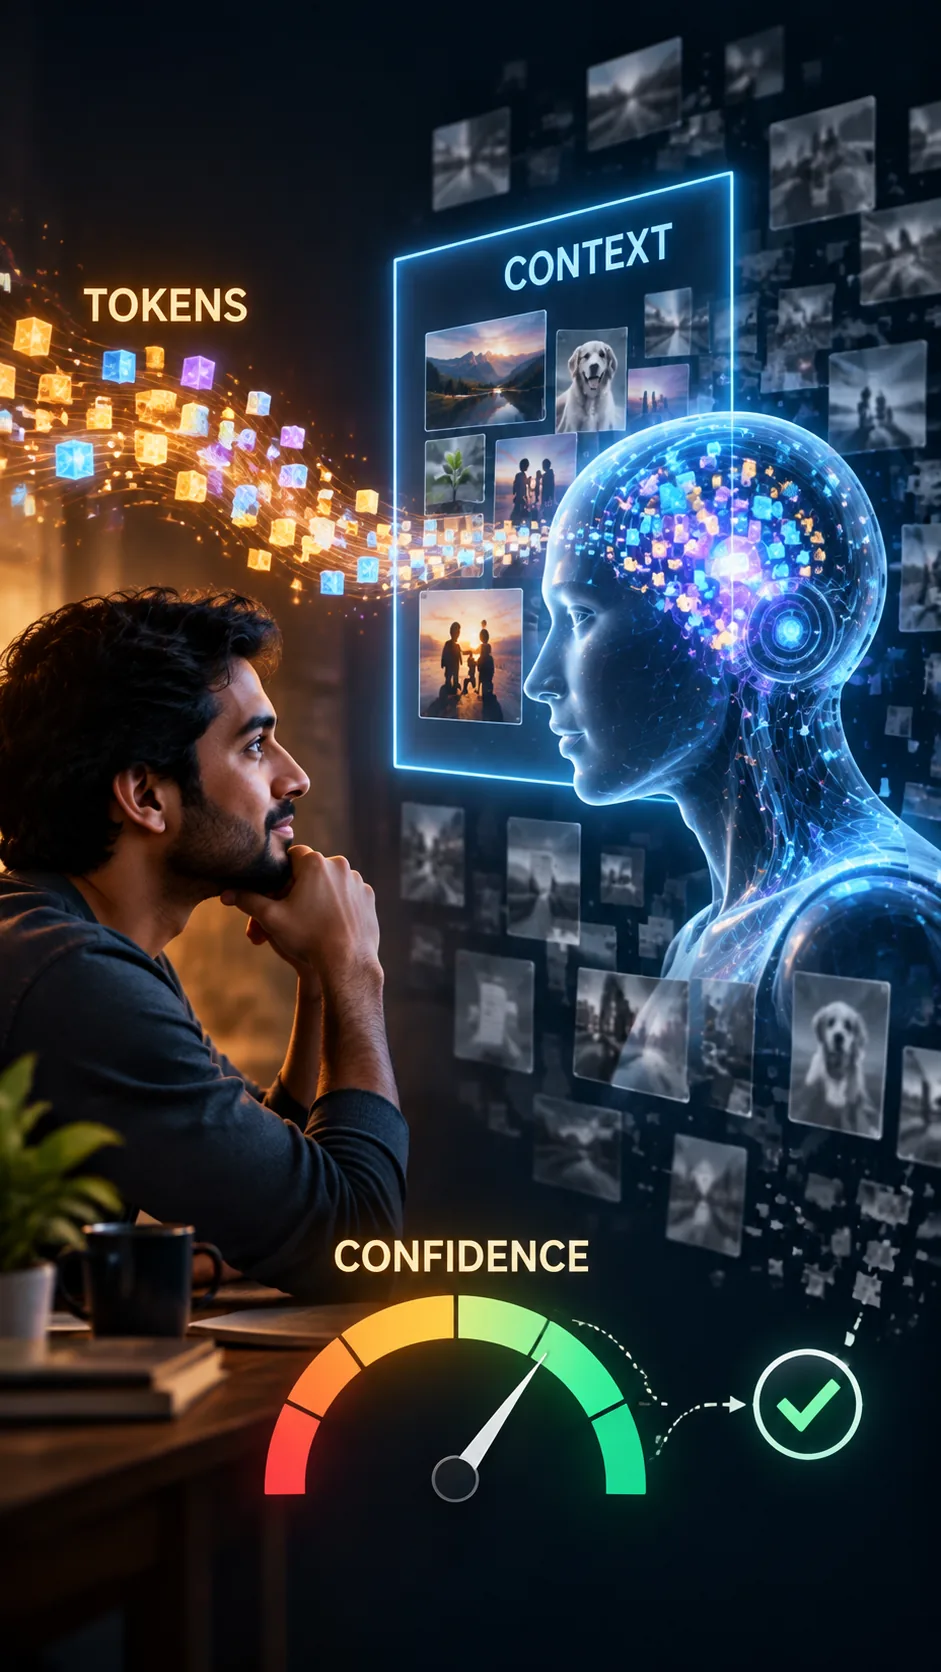
माणूस बोलताना केवळ शब्दांचा अर्थ घेत नाही, तर आवाजाचा चढ-उतार, चेहऱ्यावरील हावभाव, पूर्वीचे संभाषण आणि आजूबाजूचे वातावरण या सगळ्यांचा विचार करतो. चॅटबॉटकडे यापैकी काहीही नसते. त्याच्याकडे फक्त टेक्स्ट असतो, ज्याचे लहान तुकडे केले जातात, ज्यांना ‘टोकन’ म्हणतात. आणि एक प्रचंड मोठी सांख्यिकीय स्मृती (statistical memory) असते, जी सांगते की अशा टोकननंतर इतिहासात कोणते टोकन येण्याची शक्यता जास्त आहे. जेव्हा प्रतिसाद अस्खलित मराठीत येतो, तेव्हा आपला मेंदू त्याला एखाद्या सुशिक्षित माणसाच्या बोलण्यासारखे समजतो. अस्खलितपणाला आपण प्रामाणिकपणा मानतो. शाळेत आपण शिकलो आहोत की जो स्पष्ट बोलतो, त्याला माहिती असते. भाषा मॉडेल नकळतपणे याच गोष्टीचा फायदा घेते. त्याचे काम ‘सत्य बोलणे’ नाही, तर ‘पुढचा संभाव्य टोकन’ निवडणे आहे. सत्य अनेकदा त्या शक्यतेच्या जवळ असते, पण नेहमीच नाही. ‘समजले’ असे म्हणणारे वाक्यसुद्धा त्याच पॅटर्नमधून येते. ट्रेनिंग डेटामध्ये लाखो वेळा माणसांनी संभाषणाच्या शेवटी ‘got it’ किंवा ‘समजले’ असे लिहिले आहे. मॉडेल तीच सामाजिक औपचारिकता पुन्हा वापरते. आतमध्ये कोणीही छोटा माणूस बसलेला नाही जो खरोखर विषय समजून घेत आहे.
टोकन म्हणजे काय?
मॉडेल अक्षर-अक्षर विचार करत नाही, किंवा नेहमी पूर्ण शब्दही नाही. ते टेक्स्टला टोकनमध्ये विभाजित करते. एक टोकन कधी लहान शब्द असू शकतो, कधी शब्दाचा भाग, कधी चिन्ह किंवा कधी स्पेससहित एक युनिट. इंग्रजीमध्ये एक टोकन साधारणपणे एका लहान शब्दाच्या किंवा अक्षराच्या आसपास असतो. मराठी किंवा देवनागरी लिपीमध्ये टोकनचे विभाजन वेगळे असू शकते, कारण लिपी आणि शब्दांचे स्वरूप इंग्रजीपेक्षा वेगळे आहे. तुम्ही पाठवलेला मोठा संदेश मॉडेलसाठी टोकनची एक रांग बनतो. प्रतिसादसुद्धा टोकनची रांगच असतो, जो एकामागून एक बाहेर पडतो. त्यामुळे ‘लक्षात ठेवणे’ याचा अर्थ अनेकदा तो टोकनचा क्रम अजूनही ‘कॉन्टेक्स्ट विंडो’मध्ये आहे, असा होतो. विंडोच्या बाहेर गेलेला टोकन मॉडेलसाठी त्या क्षणी अस्तित्वात नसतो, जोपर्यंत त्याला बाहेरून पुन्हा माहिती दिली जात नाही. टोकनची संख्या पैशांची मर्यादा आणि कार्यक्षमतेची मर्यादा दोन्ही ठरवते. मोठा पीडीएफ, संपूर्ण चॅट हिस्ट्री किंवा मोठे कोडिंग हे सर्व विंडोचा भाग मागतात. विंडो भरली की जुन्या गोष्टी कट होतात. कट झाल्यानंतर मॉडेलला जुन्या गोष्टी आठवत नाहीत, कारण त्याला ‘आठवण’ असल्याची जाणीव नसते. जाणीव हा माणसाचा गुण आहे, शक्यतेचा नाही.
नेक्स्ट-टोकन प्रेडिक्शन – खरे इंजिन
मोठ्या भाषा मॉडेलचे मुख्य काम सोप्या भाषेत सांगायचे तर हे आहे: आतापर्यंत आलेल्या टोकननंतर पुढचा टोकन कोणत्या संभाव्यतेनुसार निवडायचा. लाखो संभाव्य टोकनवर शक्यता विभागलेल्या असतात. मग एक टोकन निवडला जातो – कधी सर्वाधिक संभाव्य, तर कधी थोडा यादृच्छिक (random) चवीनुसार (temperature). मग हा नवीन टोकन इतिहासात जोडला जातो आणि प्रक्रिया पुन्हा सुरू होते. संपूर्ण परिच्छेद एकाच वेळी ‘विचार करून’ तयार होत नाही. तो एकामागून एक विटा रचून भिंत बांधण्यासारखे आहे. सुरुवातीची वीट थोडी तिरकी बसली, तर भिंत तिरकी होऊ शकते – आणि मॉडेल त्याच तिरक्या भिंतीला अधिक गुळगुळीत करण्याचा प्रयत्न करते, कारण गुळगुळीत वाक्य ट्रेनिंगमध्ये चांगले मानले जाते. याला ‘नेक्स्ट-टोकन प्रेडिक्शन’ म्हणतात. समजून घेण्याची गोष्ट ही आहे की, ध्येय ‘जगाचा नकाशा अचूक ठेवणे’ हे नाही, तर ‘या क्रमानंतर डेटा मध्ये जो क्रम नैसर्गिक वाटतो, तो पुढे चालू ठेवणे’ हे आहे. डेटामध्ये चुका असतील, तर चुकीचा पॅटर्नसुद्धा नैसर्गिक वाटू शकतो. डेटामध्ये दोन विरोधी दावे असतील, तर मॉडेल कधी एक, कधी दुसरा, किंवा कधी दोन्हीचे मिश्रण देऊ शकते – ते मिश्रण अशक्य आहे हे न कळता. यामुळेच मॉडेल तुमचे अपूर्ण वाक्य पूर्ण करते. अपूर्णता त्याच्यासाठी एक क्रम आहे, ज्याला सर्वात संभाव्य मार्गाने पुढे वाढवायचे आहे. माणूस अपूर्ण वाक्यातील हेतू समजून घेतो. मॉडेल हेतू समजत नाही, फक्त सांख्यिकीय सातत्य राखते.
ट्रेनिंग डेटा आणि ज्ञानाची मर्यादा
मॉडेलमध्ये जग फाईल्सप्रमाणे साठवलेले नसते. त्यात सांख्यिकीय संबंध (statistical relationships) असतात. ट्रेनिंग दरम्यान अब्जावधी पाने, संवाद, कोड, पुस्तके, फोरम – हे सर्व टोकनच्या रांगेत रूपांतरित होऊन मॉडेलचे वजन (weights) अपडेट करतात. जी गोष्ट वारंवार, अनेक स्रोतांमध्ये, एकाच स्वरूपात येते, ती नंतर स्थिर प्रतिसाद देते. जी गोष्ट कमी वेळा येते, विरोधाभासी असते किंवा कट-ऑफ तारखेनंतर घडलेली असते, ती कमकुवत किंवा अनुपस्थित राहते. येथे तीन मुख्य मर्यादा स्पष्ट होतात:
१. **वेळ:** वजन एकदा स्थिर झाले की त्यानंतरची माहिती मॉडेलमध्ये आपोआप येत नाही, जोपर्यंत नवीन ट्रेनिंग, अपडेट किंवा बाह्य शोध साधने वापरली जात नाहीत.
२. **दुर्मिळ तथ्य:** एखादा छोटा आदेश, स्थानिक नियम किंवा खाजगी दस्तऐवजाचा तपशील डेटामध्ये नसेल किंवा इतका कमी असेल की त्यावर मॉडेलचे वजन मजबूत होणार नाही.
३. **मिश्रण:** दोन सत्य गोष्टी वेगवेगळ्या ठिकाणी होत्या; मॉडेलने त्यांना एका वाक्यात अशा प्रकारे जोडले जणू त्या एकच घटना होत्या. जोड गुळगुळीत वाटला, पण सत्य नव्हता.
‘ज्ञान’ हा शब्द येथे अनेकदा चुकीच्या पद्धतीने वापरला जातो. माणूस ज्ञान तपासणी, अनुभव आणि शंकेने जोडतो. मॉडेलच्या वजनांमध्ये फक्त पॅटर्न असतो. पॅटर्न अनेकदा ज्ञानासारखे वागतो – राजधानी, सूत्र, वाक्प्रचार. पण जिथे जग गुंतागुंतीचे आहे, तिथे पॅटर्न तुटतो: नवीन घटना, खाजगी प्रकरणे, दोन स्रोतांचा संघर्ष किंवा असा प्रश्न ज्याचे उत्तर डेटामध्ये कधीही एका वाक्यात लिहिलेले नाही.
फाइन-ट्यूनिंग (fine-tuning) आणि सिस्टम निर्देश (system instructions) मॉडेलला शैली, सुरक्षा किंवा संक्षिप्तता शिकवू शकतात. पण ते जादूने सत्य तपासणी करत नाहीत. निर्देश ‘अंदाज लावू नका’ असा असला तरी, पुढचा टोकन नकळतपणे अंदाजाकडे जाऊ शकतो, कारण अंदाजित वाक्य ट्रेनिंगमध्ये खूप आकर्षक वाटले असेल.
कॉन्टेक्स्ट विंडो – खोलीची भिंत
प्रत्येक चॅट एका खोलीसारखी असते, ज्याच्या भिंती टोकनने बनलेल्या असतात. या खोलीला ‘कॉन्टेक्स्ट विंडो’ म्हणतात. सिस्टम निर्देश, तुमचे जुने संदेश, मॉडेलचे जुने प्रतिसाद, जोडलेली फाईल – सर्व काही त्या खोलीत बसते. खोली मोठी असेल, तर लांब संभाषण टिकते. तरीही, खोली अनंत नसते. सकाळी सांगितलेली गोष्ट दुपारच्या विंडोमध्ये असू शकत नाही. मॉडेल ‘जसे तुम्ही आधी सांगितले’ असे लिहू शकते – हे सामाजिक सवय आहे, स्मृतीचा पुरावा नाही. लांब चॅटमध्ये सुरुवातीचे तथ्य दबले जाते, मधली सुधारणा हरवते आणि शेवटचा संदेश अधिक प्रभावी ठरतो. वापरकर्ता विचार करतो की संभाषण एका मेंदूसारखे आहे. प्रणाली विचार करते: या क्रमानंतर पुढचा टोकन काय? फाईल अपलोड करणेसुद्धा विंडोचा भाग मागते. संपूर्ण कादंबरी अपलोड केली, मॉडेलने सारांश सांगितला, पण पान २१४ मधील वाक्य चुकीचे सांगितले – कदाचित ते पान विंडोमध्ये पूर्ण टोकन म्हणून टिकले नसेल किंवा अटेंशनने त्याला कमी महत्त्व दिले असेल. ‘वाचले’ याचा अर्थ माणसासारखे वाचणे नाही.
अटेंशन आणि ताजगीचा पक्षपात
ट्रान्सफॉर्मर मॉडेल ‘अटेंशन’ (attention) नावाच्या यंत्रणेवर काम करतात. प्रत्येक नवीन स्थितीत, मॉडेल हे तपासते की मागील रांगेतील कोणते टोकन सध्या अधिक संबंधित वाटतात. ही यंत्रणा शक्तिशाली आहे, पण ती परिपूर्ण स्मृती नाही. लांब संदर्भात काही वाक्ये चमकतात, तर काही धूसर होतात. शेवटच्या सूचनांना अनेकदा अधिक महत्त्व मिळते – याला ‘रिकेंसी’ (recency) म्हणतात. पहिली अट दबली जाऊ शकते. म्हणूनच, एकाच चॅटमध्ये तुम्ही आधी म्हणालात ‘फक्त अधिकृत नियम पाळा’, आणि नंतर विचारले ‘तरीही अंदाजाने सांगा’, तर मॉडेल दुसऱ्या वाक्याला अधिक महत्त्व देऊ शकते. माणूस दोन्ही वाक्ये एक करार मानतो. अटेंशनचे महत्त्व बदलत राहते. दोन परस्परविरोधी सूचना एकत्र आल्यास, एक गुळगुळीत तडजोड होऊ शकते, जी दोन्हीला अर्धे तोडते. अटेंशन हे तपासत नाही की कोणते वाक्य जगात सत्य आहे. ते फक्त पाहते की कोणते टोकन या क्रमात सांख्यिकीयदृष्ट्या जोडलेले वाटते. जोड सत्यतेची हमी देत नाही.
हॅल्युसिनेशनचे मेकॅनिक्स
हॅल्युसिनेशन म्हणजे येथे कोणतीही फिल्मी भूत-प्रेत नाही. याचा व्यावहारिक अर्थ असा आहे की, मॉडेल असे तपशील देते जे अस्खलित वाटतात, प्रश्नाच्या चौकटीत बसतात, पण तथ्य, स्रोत किंवा तर्कामध्ये चुकीचे किंवा गढलेले असतात. ChatGPT हॅल्युसिनेट का करते – याचे उत्तर कोणतीही साजिश नाही, तर अनेक कारणांचा एकत्रित परिणाम आहे.
१. **’वाटणारे वाक्य’ निवडणे:** पुढचा टोकन सत्यापेक्षा ‘वाटणाऱ्या वाक्याला’ प्राधान्य देतो. न्यायालयाच्या निर्णयाचे नाव, पेपरचे शीर्षक, कलमांची संख्या – हे साचे डेटामध्ये खूप मिळतात. साच्यात नवीन नाव भरणे सोपे आहे. नाव वास्तविक असणे आवश्यक नाही.
२. **अज्ञानावर गप्प न राहणे:** ट्रेनिंगमध्ये ‘मला माहित नाही’ असे म्हणण्यापेक्षा उत्तर देणे अधिक फायद्याचे ठरले. मानवी संवादात अपूर्ण उत्तर निराशा निर्माण करते. मॉडेलने शिकले आहे की कोणतेही पूर्ण उत्तर देणे चांगले आहे. ‘माहित नाही’ हे छोटे वाक्य आहे. गढलेला पूर्ण परिच्छेद मोठे आणि समाधानकारक वाटू शकते – मॉडेलच्या स्कोअरमध्ये, जगाच्या सत्यात नाही.
३. **दुर्मिळ प्रश्न:** प्रश्न जितका विचित्र, तितका डेटा कमी. कमी डेटामुळे शक्यतेचे शिखर अनेक चुकीच्या शिखरांमध्ये विभागले जाते. मॉडेल एक शिखर निवडते आणि त्यावर निबंध लिहिते.
४. **अंतर्गत सुसंगतीचा दबाव:** पहिल्या ओळीत चुकीचे वर्ष आले. पुढील टोकन त्याच वर्षाला सत्य मानून कथा पुढे नेतात. भिंत तिरकी, प्लास्टर गुळगुळीत.
५. **वापरकर्त्याचा ढाचा:** ‘पेपरचा संपूर्ण संदर्भ द्या’, ‘केस लॉ उद्धृत करा’, ‘स्रोत सांगा’ – या सूचना मॉडेलला स्रोत-सारखी स्ट्रिंग तयार करण्यास भाग पाडू शकतात. स्ट्रिंगचे स्वरूप बरोबर, पण आतील ओळख गढलेली असू शकते. रूपाची नक्कल सामग्रीची तपासणी नाही.
६. **बहुभाषिक आणि मिश्रित तथ्य:** मराठी प्रश्न, इंग्रजी ज्ञान, अर्धा अनुवाद. एकके सरकतात – नावे, कलमे, शहरे. सरकल्याने आत्मविश्वास कमी होतोच असे नाही.
हॅल्युसिनेशन म्हणजे नेहमी खोटे बोलण्याचा हेतू नसतो. हेतू हा माणसाचा शब्द आहे. प्रणालीसाठी, हा एक उच्च-संभाव्य क्रम आहे, जो यावेळी जगाशी जुळला नाही.
आत्मविश्वास विरुद्ध अचूकता
मॉडेलच्या प्रतिसादातील विराम, जोडशब्द, ‘निश्चितपणे’, ‘स्पष्ट आहे’ – हे टोकनसुद्धा शक्यतेतून येतात. ट्रेनिंग डेटामध्ये तज्ञ अनेकदा निश्चित भाषेत बोलतात. त्यामुळे निश्चित भाषेचे सांख्यिकीय वजन जास्त असते. उच्च निश्चित भाषा म्हणजे उच्च अचूकता नव्हे. काही सिस्टीम वेगळा कॉन्फिडन्स स्कोअर (confidence score) काढण्याचा प्रयत्न करतात. तो स्कोअरसुद्धा मॉडेलची अंतर्गत शक्यता असू शकते, जगाशी जुळलेला नाही. शक्यता सांगते: या क्रमानंतर हे वाक्य किती नैसर्गिक आहे. नैसर्गिक असणे योग्य असण्यापेक्षा वेगळे आहे. माणूस उलट विचार करतो. जो आत्मविश्वासाने बोलतो, त्याला जाणकार मानतो. चॅटबॉट आत्मविश्वासाची हिचकी शैलीत कमी ठेवतो, कारण हिचकी असलेले प्रतिसाद कमी ‘पूर्ण’ वाटतात. पूर्ण वाटणे हे धोकादायक सौंदर्य आहे. म्हणूनच, चूक पकडली गेल्यानंतर मॉडेल लगेच माफी मागून नवीन आवृत्ती देऊ शकते – आणि ती नवीन आवृत्तीसुद्धा गढलेली असू शकते. माफी हा शिकलेला संवाद पॅटर्न आहे. सुधारणेची हमी नाही.
प्रॉम्प्टची अस्पष्टता
प्रश्न अपूर्ण असल्यास, मॉडेल अपूर्णता भरून काढते. ‘हे कायदेशीर आहे का?’ – कोणते राज्य, कोणती तारीख, कोणता पक्ष? रिकाम्या जागा सरासरी कथेने भरणे हे त्याचे काम आहे. सरासरी कथा तुमच्या केसशी जुळली नाही, तर तुम्हाला फसवणूक वाटते. प्रणालीने फसवणूक करण्याचा निर्णय घेतला नाही; तिने सर्वात सामान्य क्रम निवडला. अनेक सूचना एकत्र: लहान लिहा, पूर्ण लिहा, स्रोत द्या, सोपी भाषा, कायदेशीर अचूकता. या सूचना टोकन रांगेत एकमेकांना छेदतात. अटेंशन कोणालातरी जास्त वजन देईल. परिणाम अनेकदा एक गुळगुळीत तडजोड असतो, जी प्रत्येक ध्येयाला दहा टक्के तोडते. भूमिकासुद्धा गोंधळ वाढवते. ‘तू वकील आहेस’ असे लिहिल्याने मॉडेल वकिलासारखी भाषा वापरते. भाषा म्हणजे विशेषज्ञता नाही. भूमिका प्रॉम्प्टची शैली बदलते, परवाना देत नाही, कोर्ट उघडत नाही, जबाबदारी घेत नाही.
शोध, साधने आणि तपासणी – हॅल्युसिनेशन संपवतात का?
जेव्हा सिस्टीम बाह्य शोध, कॅल्क्युलेटर, कोड एक्झिक्युशन किंवा डेटाबेसशी जोडली जाते, तेव्हा काही प्रकारच्या चुका कमी होतात. ताज्या घटना, उद्धरणे, संख्या – हे वजनाच्या स्मृतीपेक्षा एखाद्या स्रोताकडून येऊ शकतात. तरीही, साखळी तुटू शकते. शोधाने चुकीचा निकाल दिला. मॉडेलने योग्य निकालाचा चुकीचा सारांश दिला. स्रोताचे वाक्य संदर्भातून कापले गेले. साधन चालले नाही, पण मॉडेल चालल्यासारखे नाटक केले – हेसुद्धा एक हॅल्युसिनेशन आहे, साधनांच्या युगात. रिट्रीव्हल (retrieval) दस्तऐवजाचे तुकडे विंडोमध्ये चिकटवते. तुकडे अपूर्ण असल्यास, चुकीचे पान असल्यास किंवा प्रश्नाशी हलके जोडलेले असल्यास, प्रतिसाद त्याच अपूर्णतेला गुळगुळीत करेल. ‘स्रोत साहित’ तरीही स्रोताबाहेरील ओळ जोडू शकते, कारण जोडण्याची सवय मजबूत आहे. तपासणी हे माणसाचे काम राहते. विशेषतः: नावे, तारखा, कलमे, औषधांचे प्रमाण, पैशांचा हिशोब, उद्धरणे. जी गोष्ट जगात एक रेकॉर्ड ठेवते, तिला रेकॉर्डशी जुळवा. जी गोष्ट मत आहे, तिला मतच राहू द्या. मॉडेल दोन्ही गोष्टी समान गुळगुळीतपणाने लिहू शकते.
दैनंदिन परिणाम: कुठे फटका बसतो?
आरोग्य, कायदा, कर, गुंतवणूक – येथे अस्खलित चूक महाग पडू शकते. शाळेचा गृहपाठ – गढलेले उद्धरण पकडले जाते. ऑफिसची धोरणे – मॉडेल जुन्या चॅटमधील अपूर्ण गोष्ट नियम बनवते. कोड – एखादे फंक्शन नावाप्रमाणे चालते, जे लायब्ररीत अस्तित्वातच नाही. कमी जोखमीच्या जागासुद्धा आहेत: एखाद्या कल्पनेला आकार देणे, भाषा सुधारणे, आराखडा सुचवणे, मसुद्याचा सांगाडा तयार करणे. तिथे मॉडेल कामाचा साथीदार आहे, साक्षीदार नाही. फरक हेतूचा आहे. साक्षीदाराकडून पुरावा मागतात. साथीदाराकडून मसुदा. मसुद्याला पुरावा मानणे ही तीच जुनी चूक आहे – अस्खलितपणाला ज्ञान मानणे.
सल्ला
मशीनशी बोलताना तीन खाणी तयार करा.
१. **तपासण्यायोग्य:** जे तपासले जाऊ शकते – नावे, आकडेवारी, कलमे, लिंक्स, अवतरणे. यांना प्रतिसादानंतर मूळ स्रोतावर तपासा.
२. **संरचना:** जे संरचनात्मक आहे – रूपरेषा, प्रश्नांची यादी, भाषेची स्वच्छता. यांना स्वतंत्र विचारांची मदत माना.
३. **आत्मविश्वास:** जे आत्मविश्वास दर्शवते – ‘निश्चित आहे’, ‘स्पष्ट आहे’. या शब्दांना सजावट समजा, पुरावा नाही.
एका चॅटमध्ये एकच काम द्या. लांब कादंबरीत दहा सूचना एकत्र करू नका. आवश्यक अटी शेवटी पुन्हा सांगा, कारण रिकेंसी अटेंशनला खेचते. फाईल दिल्यास विचारा की कोणते पान वापरले गेले; प्रतिसादात पान न मिळाल्यास, सारांश अपूर्ण असू शकतो असे समजा. गढलेल्या संदर्भाची भूक कमी करा. ‘पाच पेपरचे संपूर्ण APA रेफरन्स द्या’ यासारख्या सूचना स्रोत-सारखी स्ट्रिंग मागवतात. चांगला आदेश: ‘जे निश्चित नसेल ते लिहू नका; अनिश्चितता वेगळ्या ओळीत सांगा.’ तरीही हमी नाही. हमी फक्त तुमची तपासणी आहे. महत्त्वाचे निर्णय – औषध, खटला, कर, मोठी रक्कम – पात्र व्यक्ती आणि अधिकृत पानांशिवाय अंतिम करू नका. चॅटबॉट तिथे पहिला मसुदा असू शकतो, अंतिम सही नाही. चूक लक्षात आल्यास, त्याच चॅटमध्ये सुधारणेवर पूर्ण विश्वास ठेवू नका. नवीन कतार जुन्या चुकीला आधार मानून आणखी सजावट करू शकते. तथ्य बाहेर काढा, वेगळ्या ठिकाणी तपासा, मग स्पष्ट सूचनेसह छोटा प्रश्न विचारा.
💡 **कॉलआउट:** जे वाक्य सुंदर वाटते, त्याला आधी संशयाच्या मेजावर ठेवा. सुंदरता मॉडेलचे कौशल्य आहे; सत्य जगाचा गुण आहे. दोन्ही एका टोकनमध्ये बांधलेले नाहीत. मुलांना आणि नवशिक्यांना हेच एक वाक्य शिकवा: हे साधन पुढचा शब्द जोडते, साक्षीदार बनत नाही. साधन चांगले असू शकते. साक्षीदार वेगळी परीक्षा देतो.
निष्कर्ष
चॅटबॉट तुम्हाला ‘समजत’ नाही कारण त्याच्याकडे समजणारा मेंदू नाही, तर टोकनची रांग आणि नेक्स्ट-टोकन प्रेडिक्शन आहे. ट्रेनिंग पॅटर्न देते, अनंत ज्ञान नाही. कॉन्टेक्स्ट विंडो खोली मर्यादित करते. अटेंशन काही ओळींना चमकवते, बाकीच्यांना धूसर करते. हॅल्युसिनेशन अनेकदा त्याच इंजिनचा साइड इफेक्ट आहे, जे वाक्याला इतके मानवी बनवते – शक्यतेचे गुळगुळीत सातत्य, जेव्हा डेटा कमी असतो, सूचना एकमेकांना छेदतात किंवा रूपाची नक्कल सामग्रीपेक्षा पुढे जाते. आत्मविश्वासाची भाषा अचूकतेची पावती नाही. साधने आणि शोध काही त्रुटी भरून काढतात, सर्व नाही. शहाणपण यात आहे की मशीनला जादूच्या खुर्चीवरून उतरवून मेजावर एक साधन म्हणून ठेवा. साधन धारदार असते. साधन स्वतःच्या कामाची जबाबदारी घेत नाही. ती तुमच्यावर राहते.
FAQ
- चॅटबॉट जाणूनबुजून खोटे बोलतो का?
नाही, त्या अर्थाने नाही ज्या अर्थाने माणूस खोटे बोलतो. तो पुढचा संभाव्य टोकन निवडतो. कधीकधी तो निवड जगाशी जुळत नाही. हेतूचा नाटक वाचू नका; प्रणाली वाचा. - लांब चॅटमध्ये तो माझी जुनी गोष्ट का विसरतो?
कॉन्टेक्स्ट विंडो मर्यादित असते. जुने टोकन कट होऊ शकतात किंवा अटेंशनमध्ये कमी महत्त्वाचे ठरू शकतात. ‘विसरणे’ ही मनाची कमजोरी नाही, तर क्रमाची मर्यादा आहे. - काय चांगले प्रॉम्प्ट हॅल्युसिनेशन संपवतात?
कमी होऊ शकते, पण संपत नाही. स्पष्ट चौकट, ‘माहित नसेल तर सांगा’, छोटे प्रश्न मदत करतात. दुर्मिळ तथ्य आणि स्रोत-मागणी अजूनही गढलेले स्वरूप आणू शकते. - शोध किंवा प्लगइन चालू असल्यास उत्तर नेहमीच बरोबर असते का?
नाही. चुकीचा निकाल, चुकीचा सारांश, अपूर्ण तुकडा किंवा साधन नसताना साधनासारखे नाटक करण्याची शक्यता असते. स्रोत उघडा. - अस्खलित प्रतिसादाचे वाचन कसे करावे?
ढाचा आणि भाषेसाठी उपयुक्त माना. नावे, तारखा, आकडेवारी, कायदे, औषधे, अवतरणे बाह्य रेकॉर्डशी जुळवा. निश्चित स्वरूपाला सजावट समजा.
डिस्क्लेमर: ही सामान्य तांत्रिक माहिती आहे, कोणत्याही विशिष्ट उत्पादनाची हमी किंवा कायदेशीर सल्ला नाही. महत्त्वाच्या विषयांवर अधिकृत स्रोत आणि पात्र व्यावसायिकांकडून तपासणी करा.